一、AI分离人声和背景音乐的核心原理
1.频谱特征识别:音频会转化为频谱图谱,AI学习区分人声与乐器的频率、音色特征。人声的频段、泛音规律和鼓、吉他、钢琴等乐器有明显区别;
2.深度学习模型推理:预训练AI模型海量学习各类歌曲、录音样本,自动区分属于人声的信号和背景音乐信
号;3.信号重构输出:模型将识别出的两类信号分别重建,生成独立的人声音频与伴奏音频,尽量减少音质损耗。
注意:如果人声和乐器频段高度重叠、混响很重,很难做到100%完全干净分离,会残留少量杂音。
二、AIFooler人声与背景音乐分离步骤
1.上传音频素材
浏览器打开AIFooler官网,进入人声伴奏分离功能,上传歌曲、录音音频,支持MP3、M4A、WAV等主流格式。
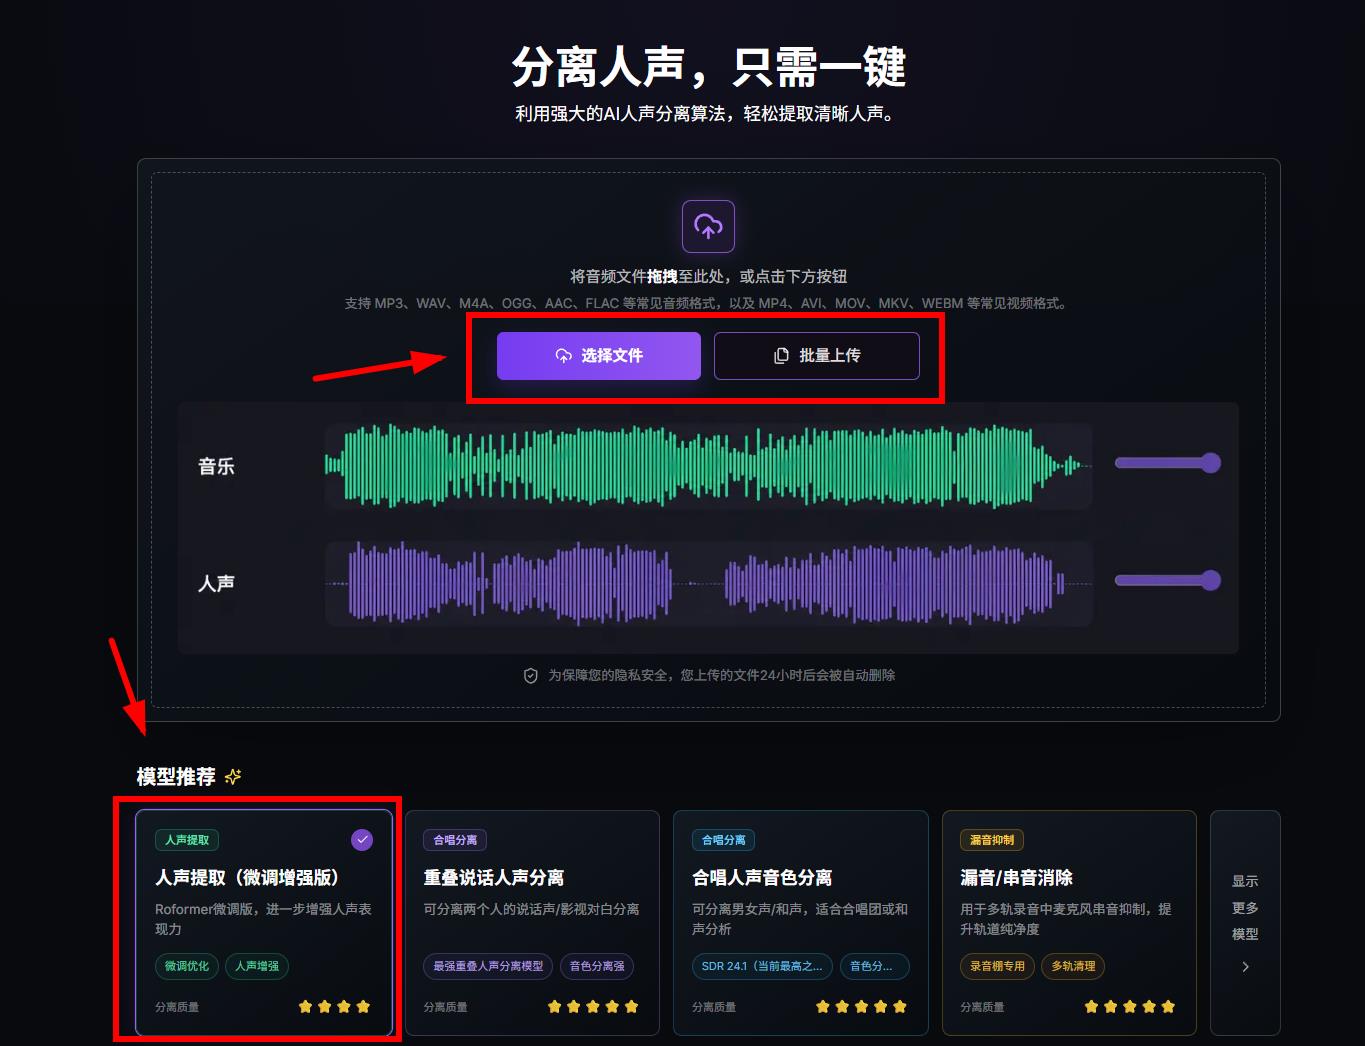
2.启动AI自动分离
选择【人声提取】模型或者【伴奏提取】分离模型,提交任务,AI自动识别频谱并拆分音轨,分为人声和伴奏两条音轨,无需手动调节复杂参数。
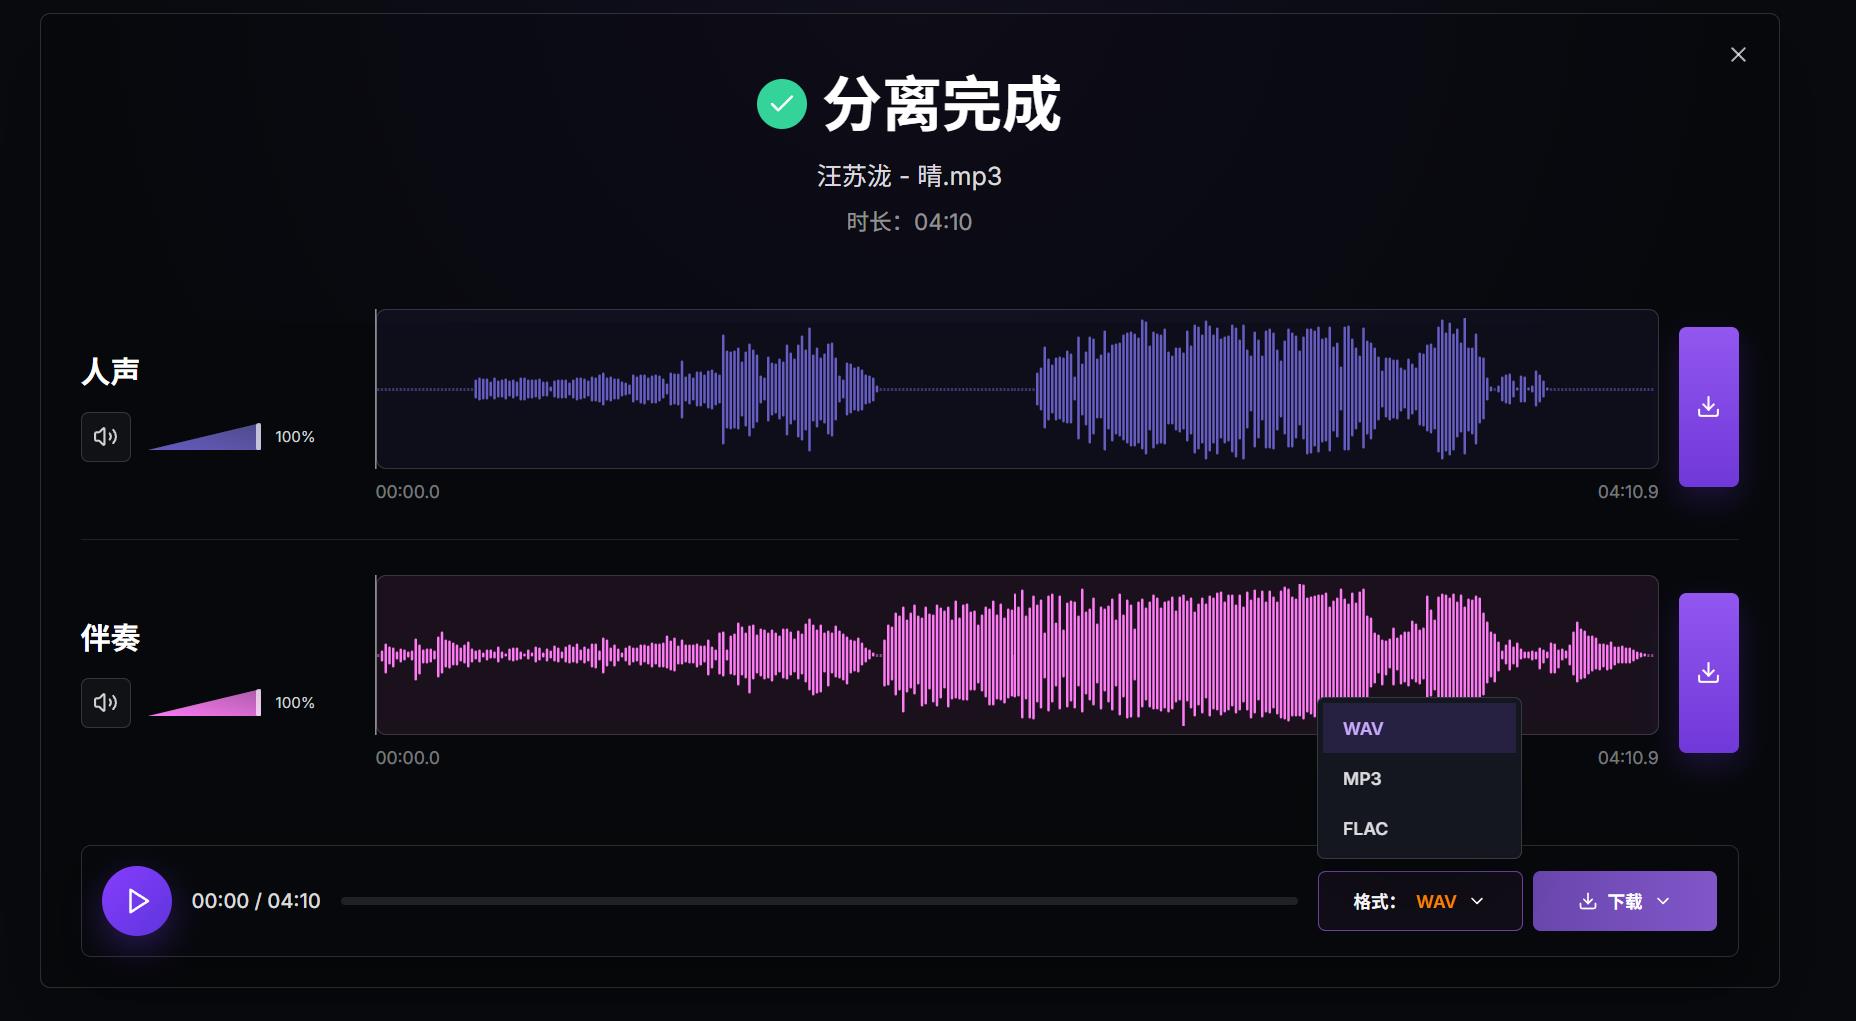
3.分别下载素材
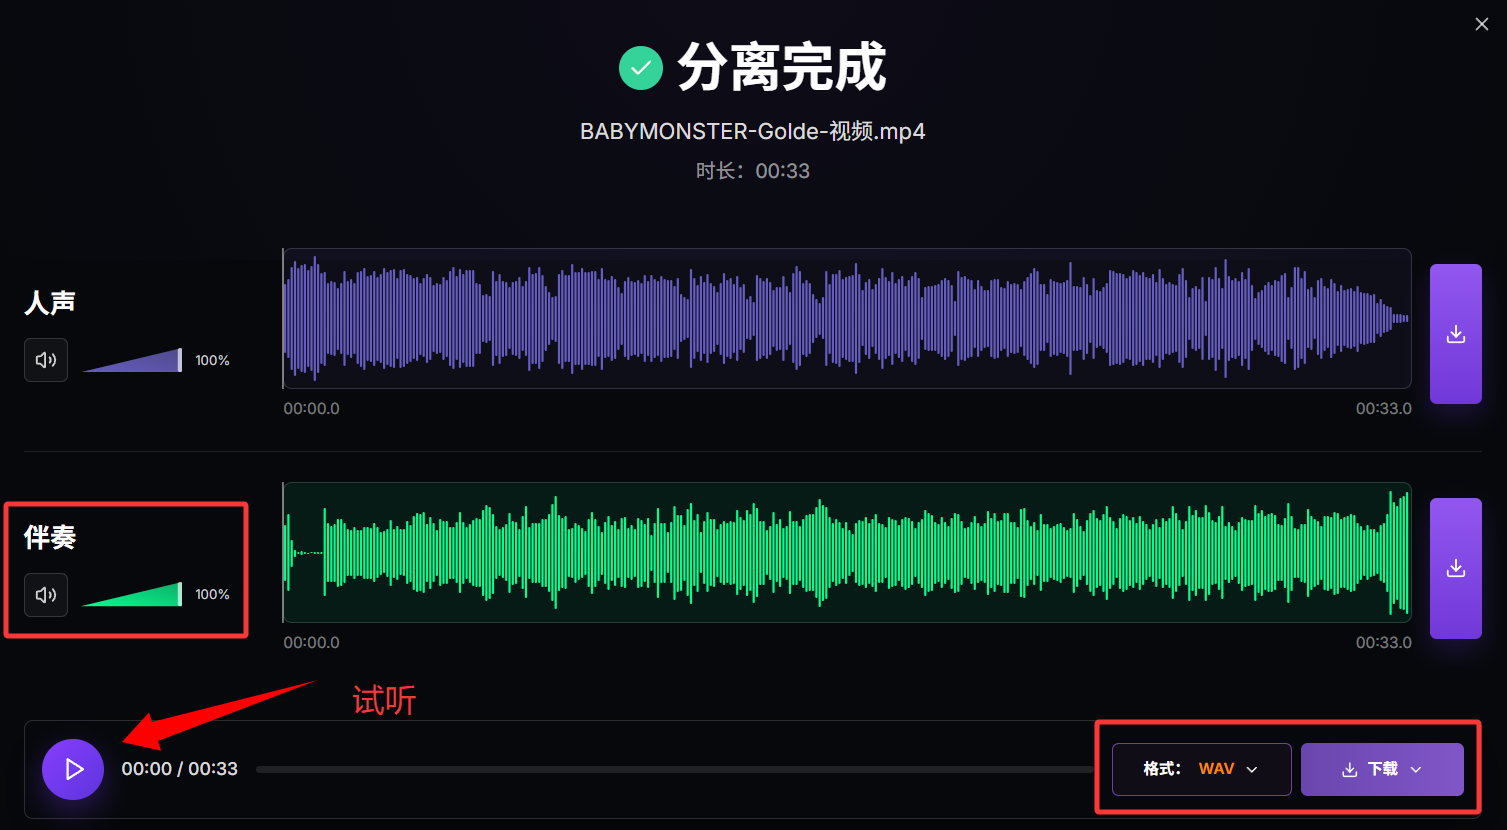
处理完成后,可预览试听纯人声、纯伴奏两条音频,确认效果后分别保存到本地,直接用于剪辑、翻唱使用。
为什么有时候分离后还会有音乐残留?
需要注意的是,人声和背景音乐并不是完全独立的声音。例如歌手唱歌时,人声和乐器可能处于相同的频率范围;如果伴奏中还有合唱、和声、混响等声音,它们也可能与主唱产生重叠。因此,即使使用AI分离,也可能出现:
- 人声中残留少量伴奏
- 伴奏中残留人声人声
- 出现轻微失真或金属感
- 混响、和声比较难完全分离
一般这种时候可以更换模型进行二次处理,或者直接进行人声降噪。
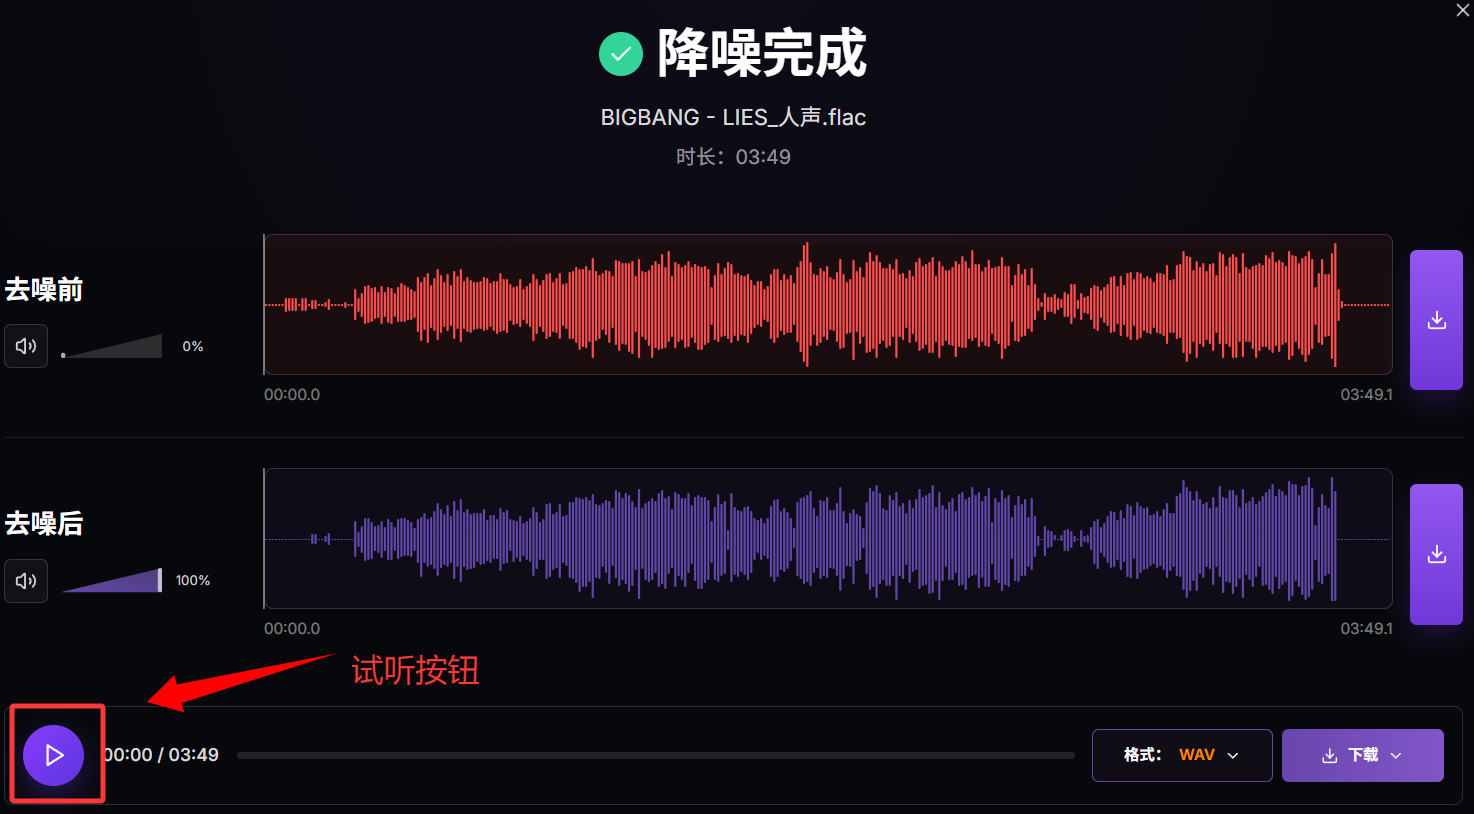
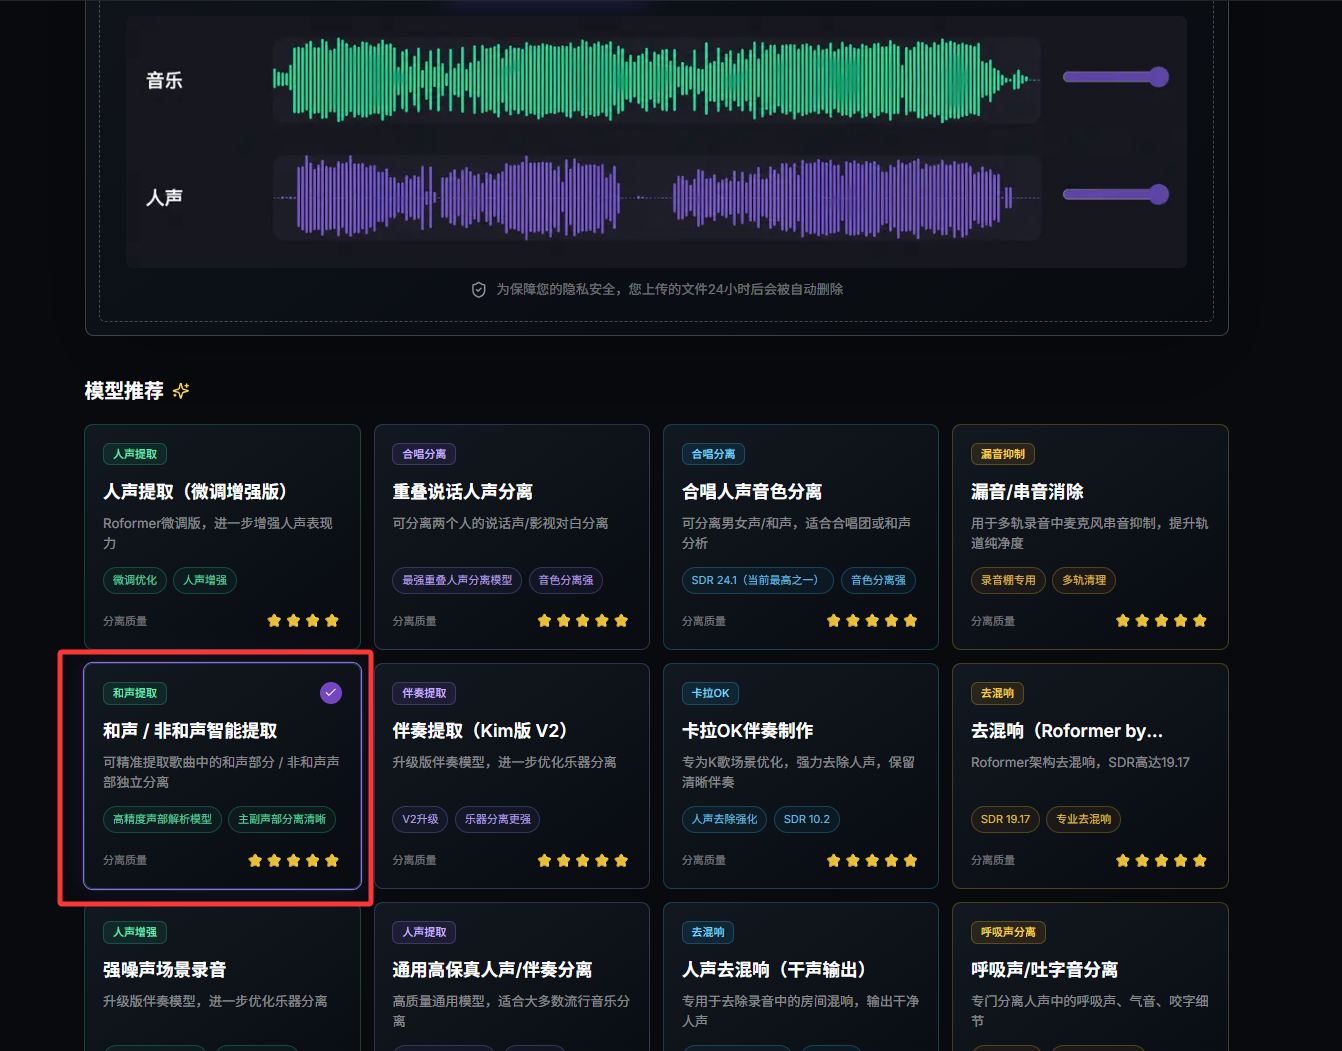
注意的是如果要多次处理,那么推荐每次保存wav无损格式,能够较为比较好的保留音乐音质。
人声和背景音乐分离,本质上是从已经混合的音频中,根据不同声音的频率、时间变化和音色特征识别并提取目标声音。传统方法主要依赖信号处理,而现在的AI分离技术则更多依靠模型对声音特征的学习和预测。aifooler是目前比较好的音频处理工具,同时还提供多种音频处理知识技巧给大家。