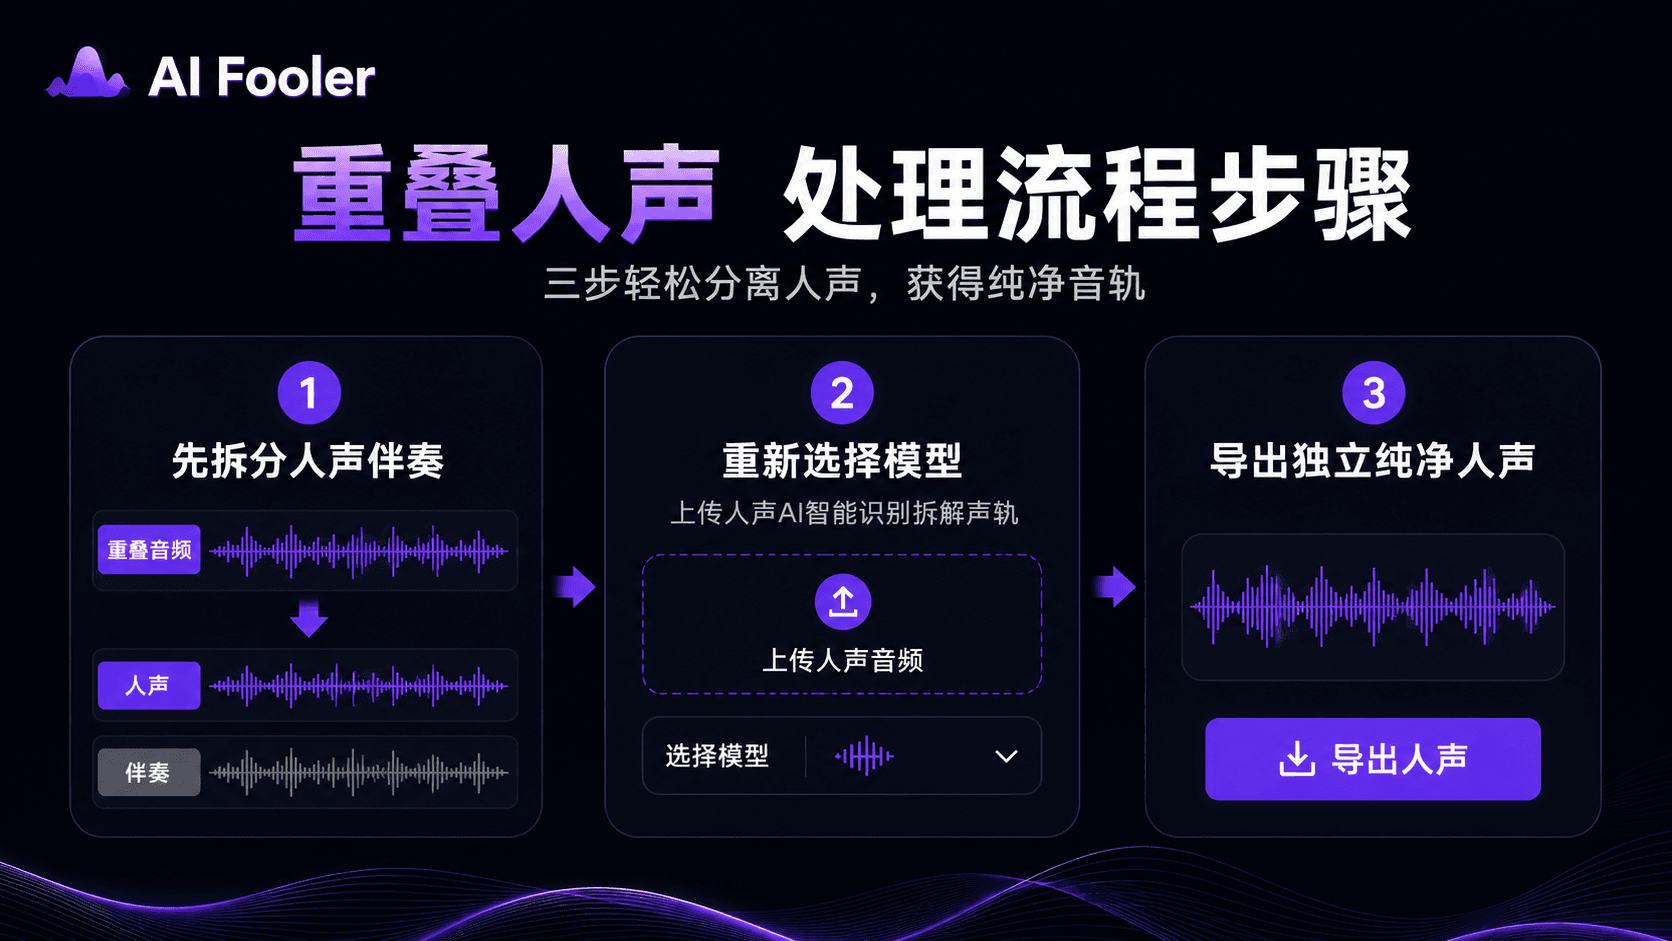
重叠人声分离最简单三个步骤
步骤1:先去除歌曲中的背景音乐
首先打开AIFooler,上传需要处理的目标音频。进入人声分离功能后,先使用默认分离模型,将歌曲中的BGM与人声进行拆分。
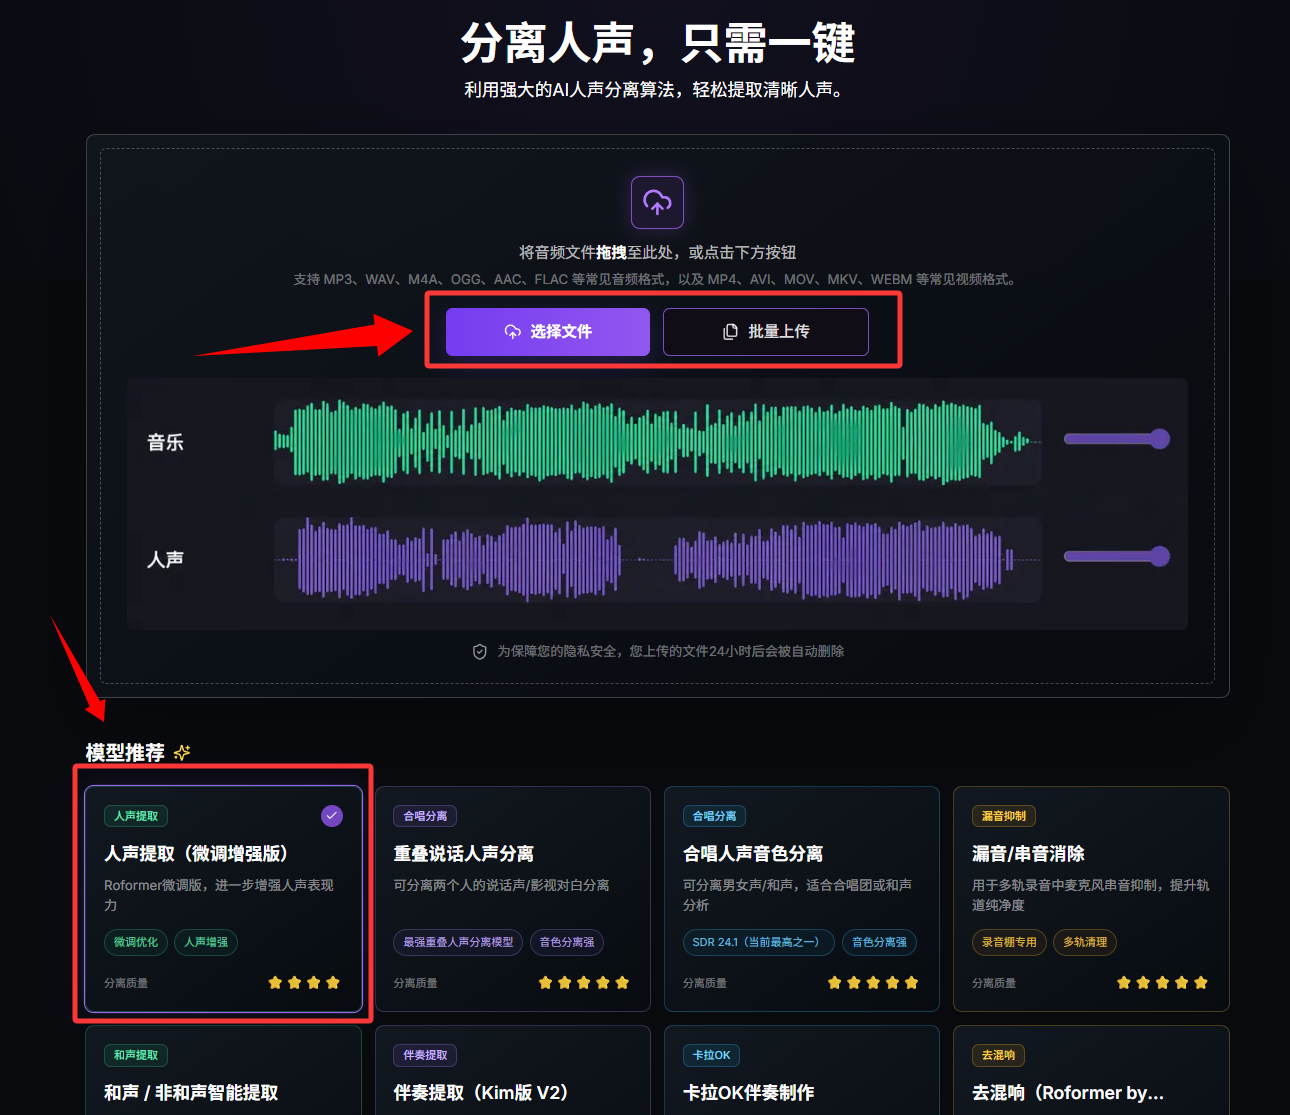
处理完成后,不需要保留伴奏文件,只需导出其中的纯人声音频,作为后续处理素材。
【这一步主要是把复杂的音乐背景去掉,让后续模型可以更加集中地处理两个人重叠的人声。】
步骤2:根据场景选择重叠人声模型
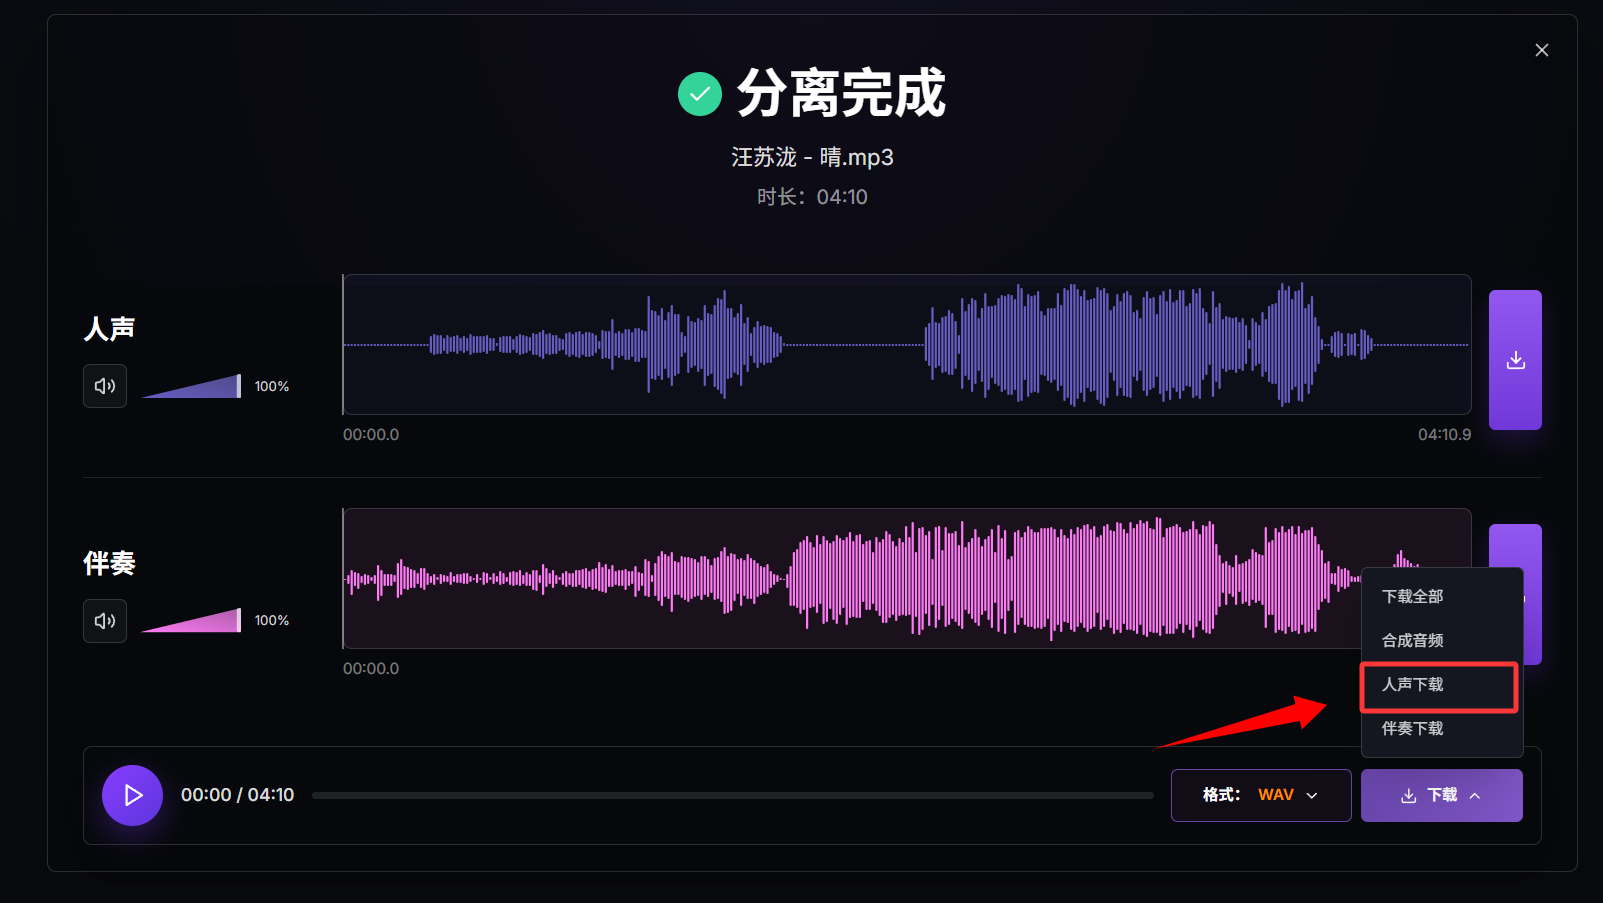
将上一步提取出来的纯人声文件再次上传到AIFooler。接下来需要根据音频类型选择对应的分离模型。
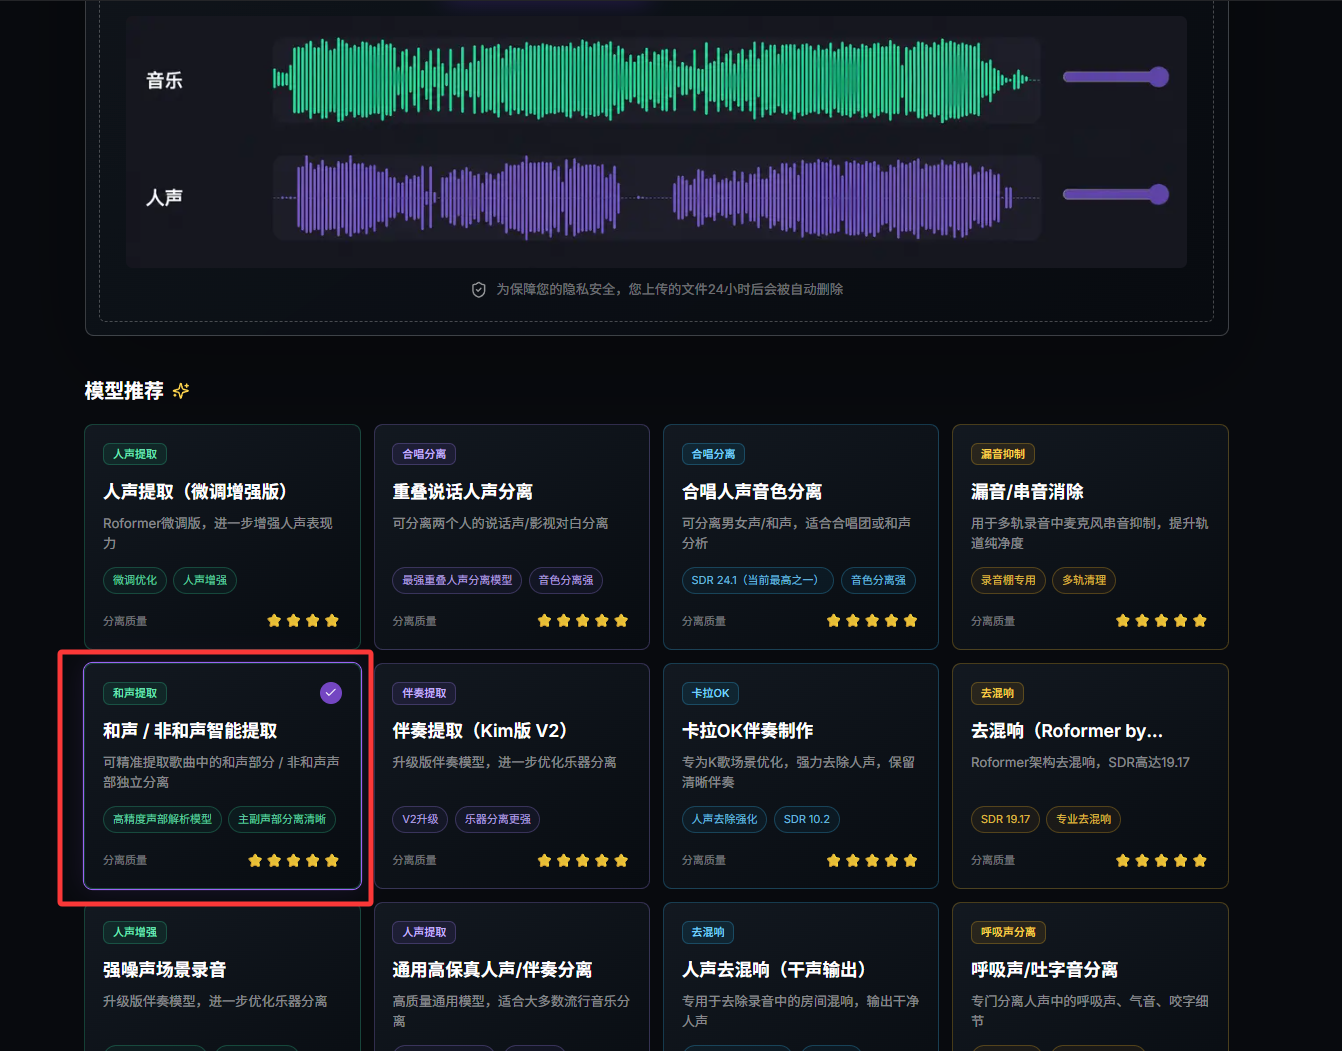
如果是两个人同时说话,例如采访、访谈或双人对话,可以选择【重叠说话人声分离】或【男女对话】模型,用于进行双人男女声拆分。
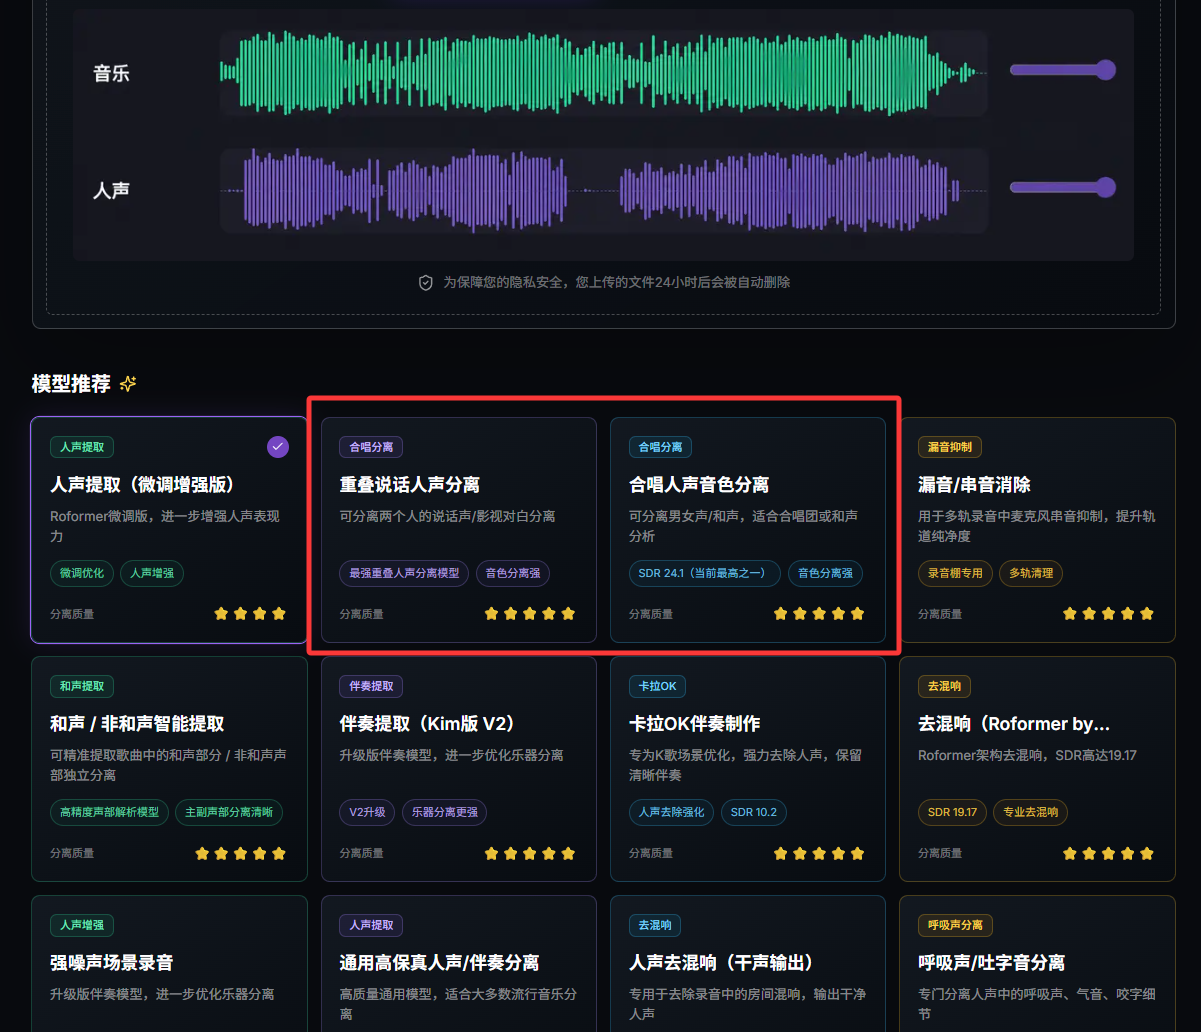
如果是两个人同时唱歌,而且其中一人的声音相对较小,可以根据实际情况选择【和声/非和声】进行二次拆分。
步骤3:试听单人音轨并进行降噪
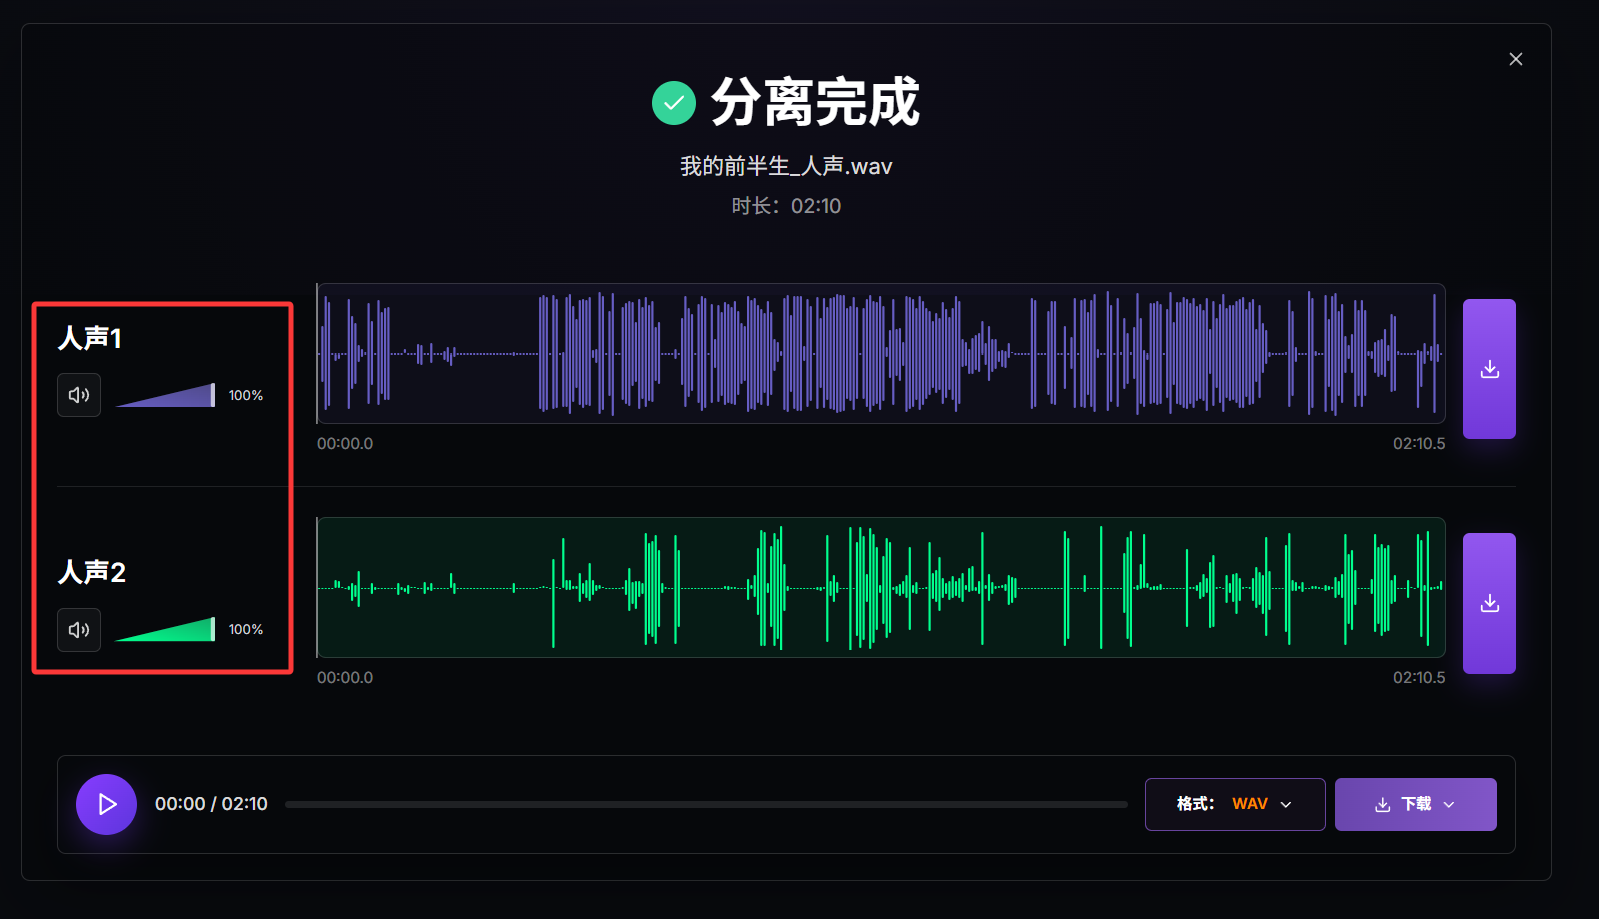
选择模型后开始处理,等待系统完成音频分析和分离。处理完成后,可以分别试听生成的单人音轨,检查两个人的声音是否已经按照预期拆分。
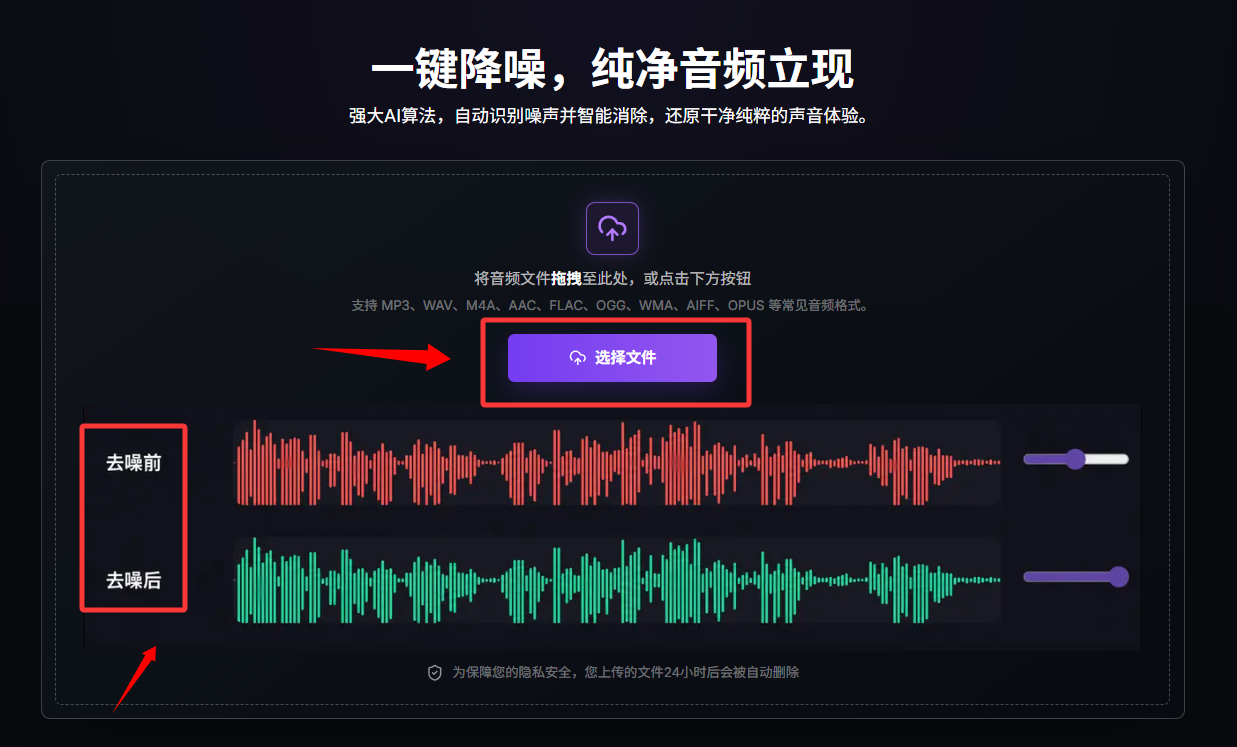
如果音频本身比较干净,可以直接保存分离结果。如果试听时发现存在明显底噪、环境杂音等问题,可以继续使用AIFooler的一键音频降噪功能进行处理。
使用小贴士
原始录音质量很重要。录音越清晰,人物声音之间的区别越明显,后续处理通常也更容易。如果原始音频本身存在严重噪声、失真或声音过小,可能会影响最终分离效果。
根据音频类型选择模型。两人同时讲话时,优先考虑【重叠说话人声分离】或【男女对话】模型;
两人唱歌且存在和声交织时,可以尝试和声模型。不同场景应选择对应的处理方式。
导出格式按用途选择。如果后续还要进行剪辑、混音等处理,可以优先选择质量较高的音频格式;用于日常试听或分享时,MP3等常见格式更加方便。
主唱跟和声重叠怎么处理?
如果重叠的不是两个人的对话,而是歌曲中的主唱与和声,需要先明确想要保留的内容。
例如,想提取主唱进行翻唱,可以先使用人声分离功能分离人声与伴奏;如果主唱和和声已经混合在人声轨道中,分离结果可能仍然包含两者。
如果希望单独保留主唱、去除和声,就需要选择支持主唱与和声进一步分离的模型,比如和声模型。普通的人声分离主要处理人声和伴奏之间的区别,不能保证把主唱与和声分别输出。
对于已经分轨的音乐素材,可以直接检查是否存在独立的主唱轨、和声轨,再根据需要选择保留或删除对应轨道。
重叠人声分离不干净怎么办?
- 检查原始录音: 如果背景噪声较大、声音失真严重,或者两个声音的音色十分接近,分离难度会增加。
- 缩短处理片段: 如果工具支持分段处理,可以先截取重叠比较明显的部分单独测试,再对比处理结果。
- 尝试不同的分离方式: 区分人声与伴奏的模型,不一定适合区分两个说话者,应根据目标选择相应的工具。
- 适当进行降噪: 如果录音还包含持续的环境噪声,可以尝试降噪改善听感,但降噪不能保证去除另一个人的声音。
- 保留原始音频: 多次处理可能造成声音细节损失,建议保存原文件,比较不同结果后再决定使用哪个版本。
两个人同时说话,怎么只保留其中一个?
- 如果录音中有两个人同时讲话,而你只想保留其中一个人的声音,可以根据音频条件尝试以下方法。
- 方法一:使用支持说话人分离的工具
- 选择能够区分不同说话者、输出独立人声轨道的音频处理工具。如果工具支持指定说话人或选择目标声轨,可以先识别目标人物对应的声音,再导出对应音轨。
- 这类工具的实际效果取决于录音质量、两个人的音色差异、重叠时长等因素。如果两个人同时发声的时间较长,即使使用专门工具,也可能出现残留或失真。
- 方法二:利用没有重叠的片段辅助处理
- 如果两个人并非全程同时说话,可以先找到目标人物单独讲话的片段,确认其声音特征,再使用支持说话人识别的工具进行处理。
- 对于没有重叠的部分,也可以直接裁剪并保留目标人物的发言。但如果两个人在同一时间说话,单纯裁剪只能删除一整段内容,无法精准去掉其中一个人的声音。
- 方法三:从多轨录音中单独提取目标声道
- 如果录音来自会议设备、麦克风或专业录音软件,并且两个人分别录制在不同轨道或声道中,可以尝试直接提取目标轨道。这通常比从已经混合在一起的单条音频中分离两个人更容易。
- 不过,如果两个声音在录制时已经混合到同一条音轨中,就不能简单地通过切换左右声道来保证分离效果。
按照“去除BGM—二次选择模型—试听并降噪”的流程,就可以使用AIFooler处理两人以内的重叠人声,适用于男女对话人声分离、双人对话以及合唱和声等场景。