aifooler网站功能介绍
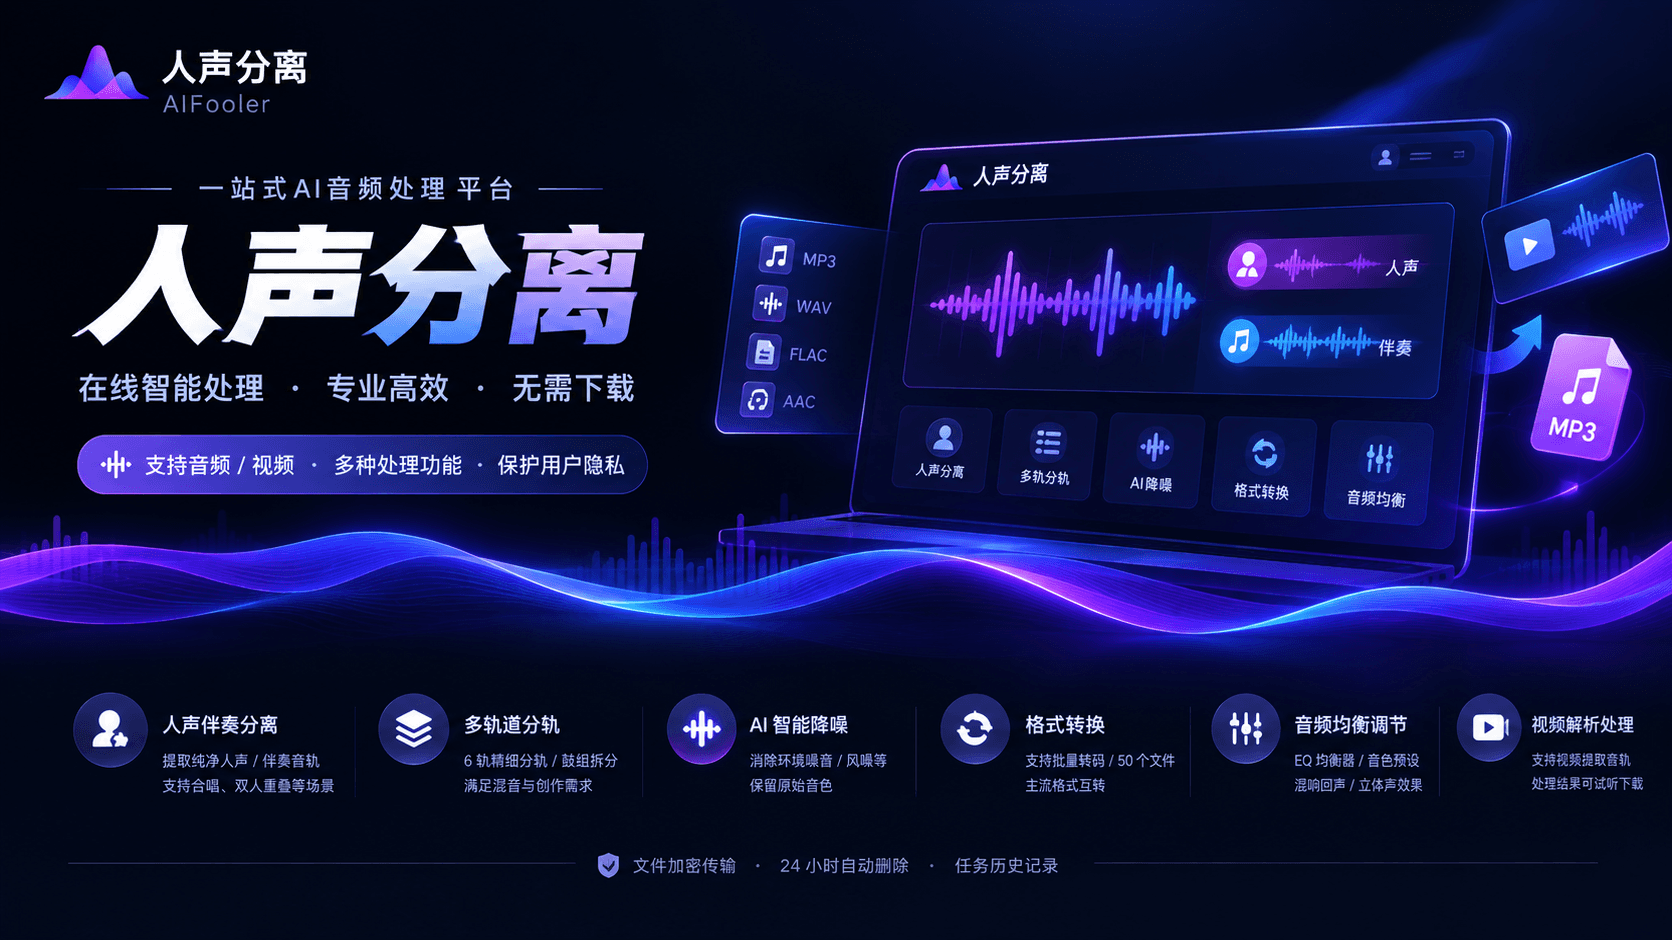
1. 人声伴奏分离:
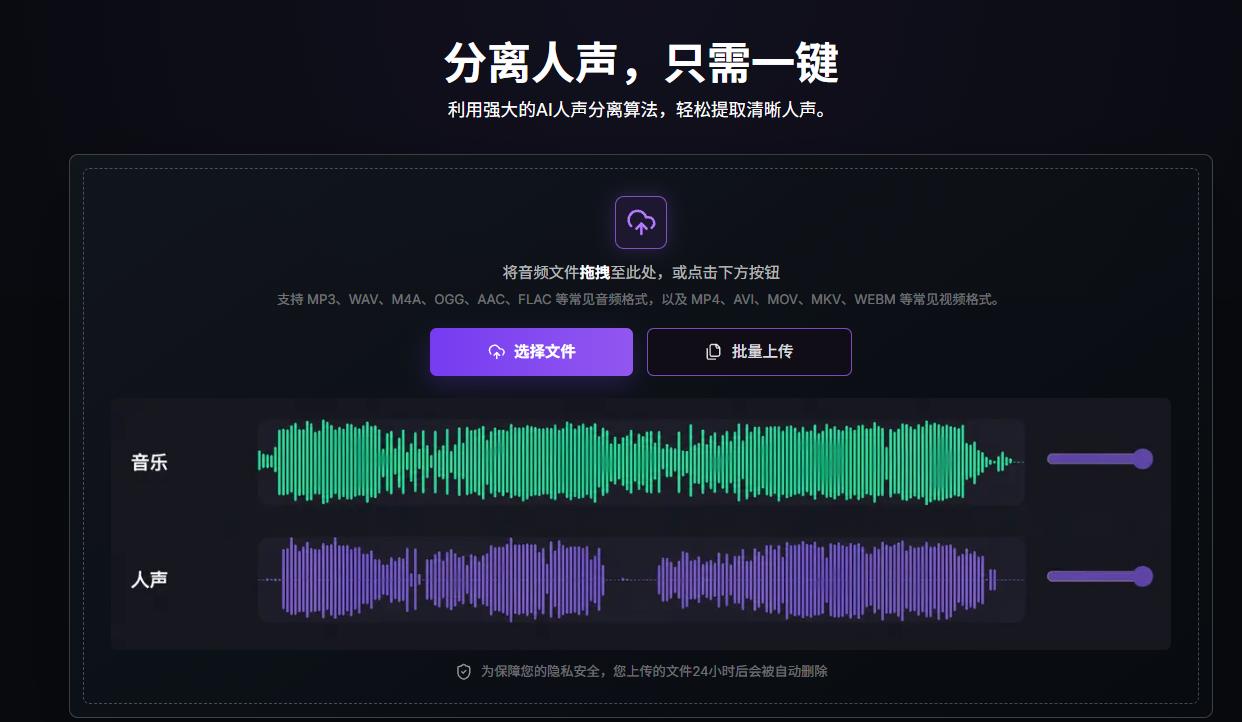
支持从音频、视频文件中提取纯净人声、伴奏音轨;提供人声提取微调增强模型、合唱分离模型,可处理双人重叠说话、影视对白分离场景AI Fooler。
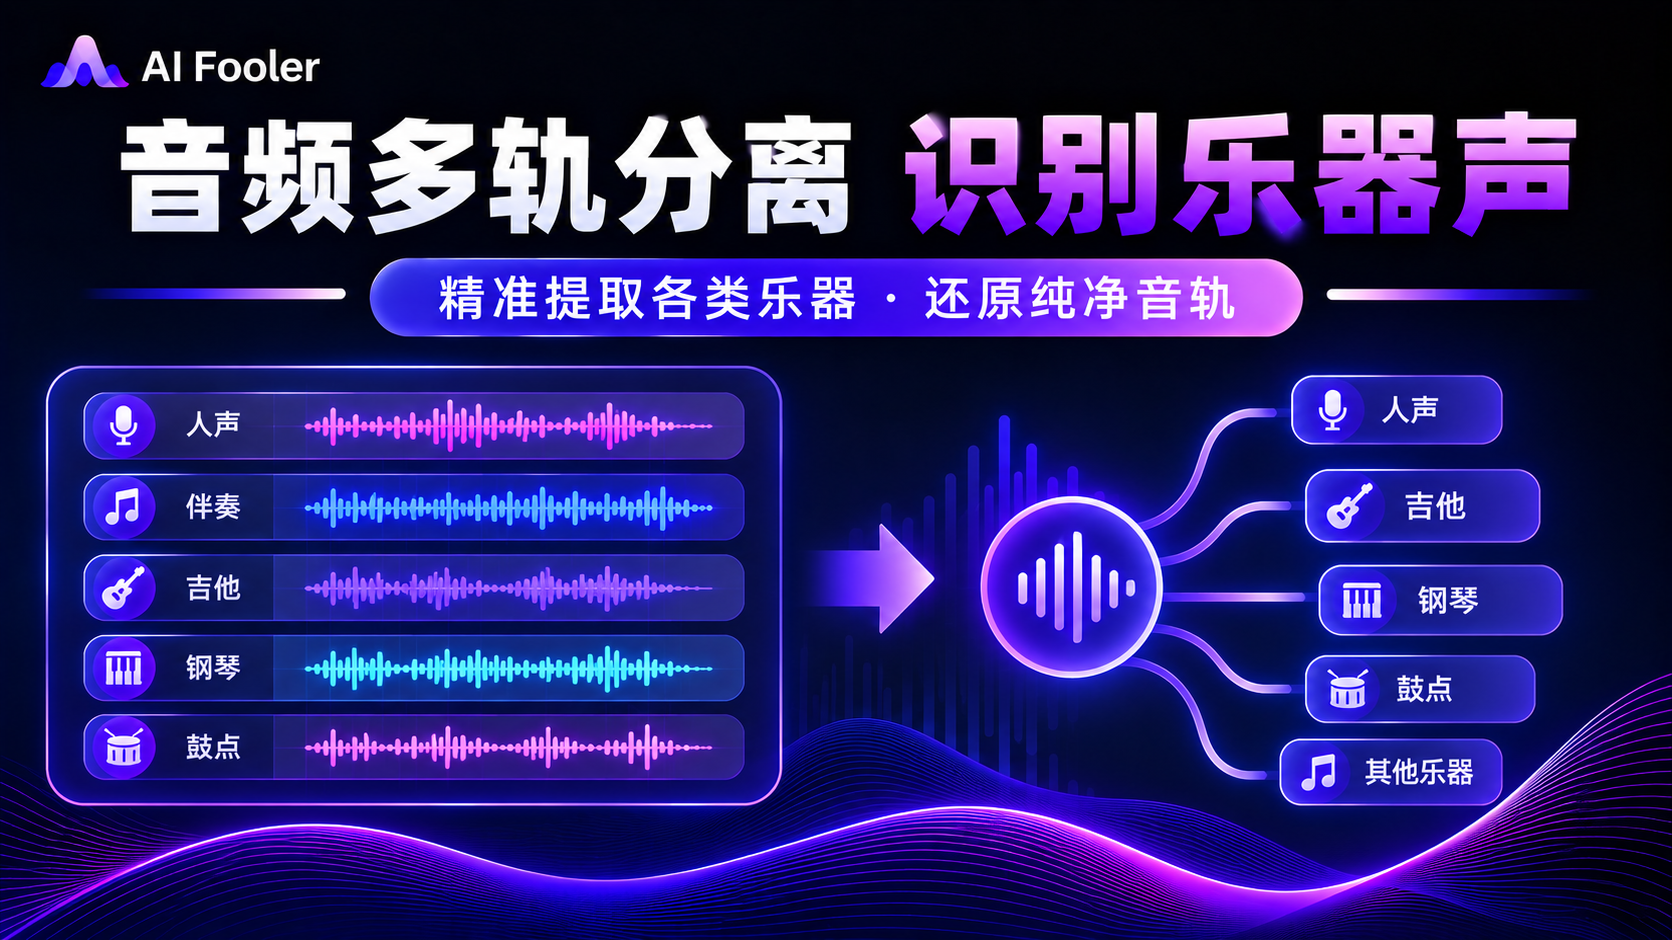
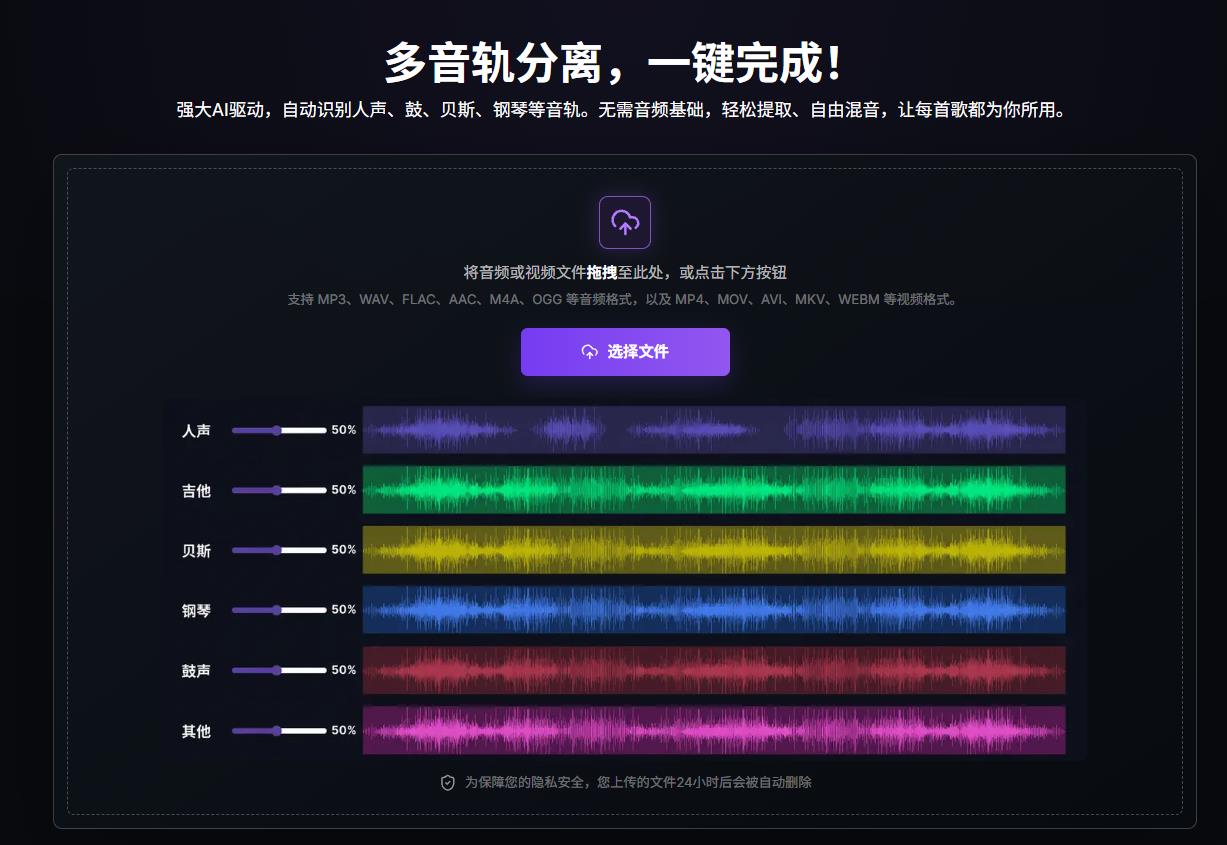
2. 多轨道分轨(Stem 分离):
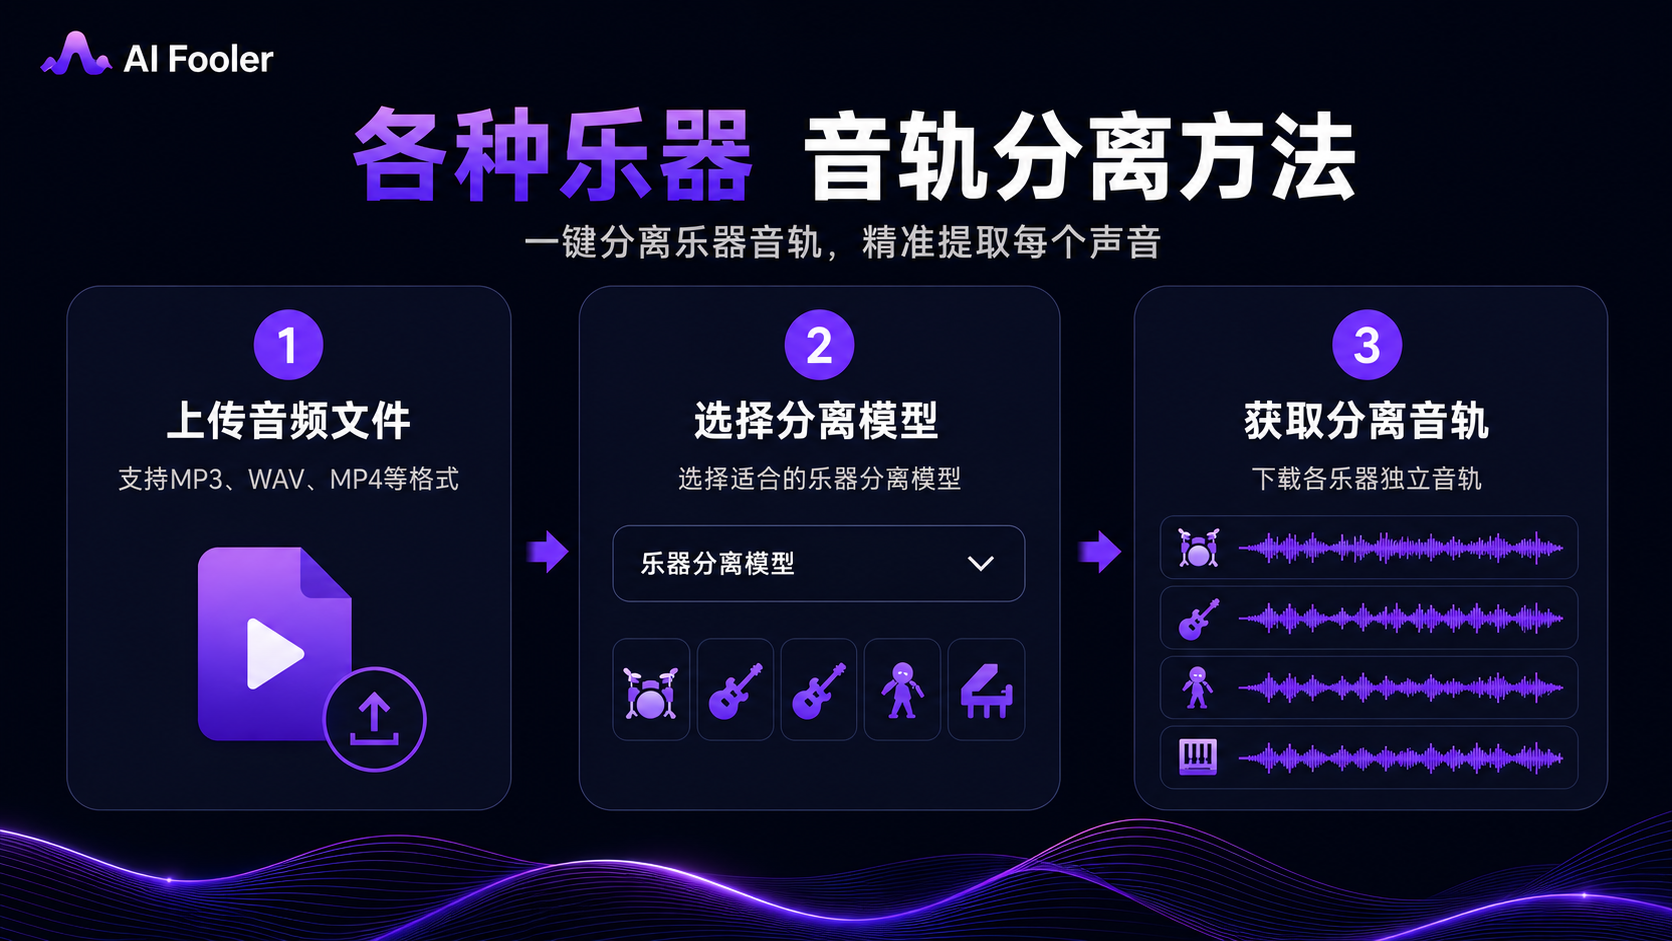
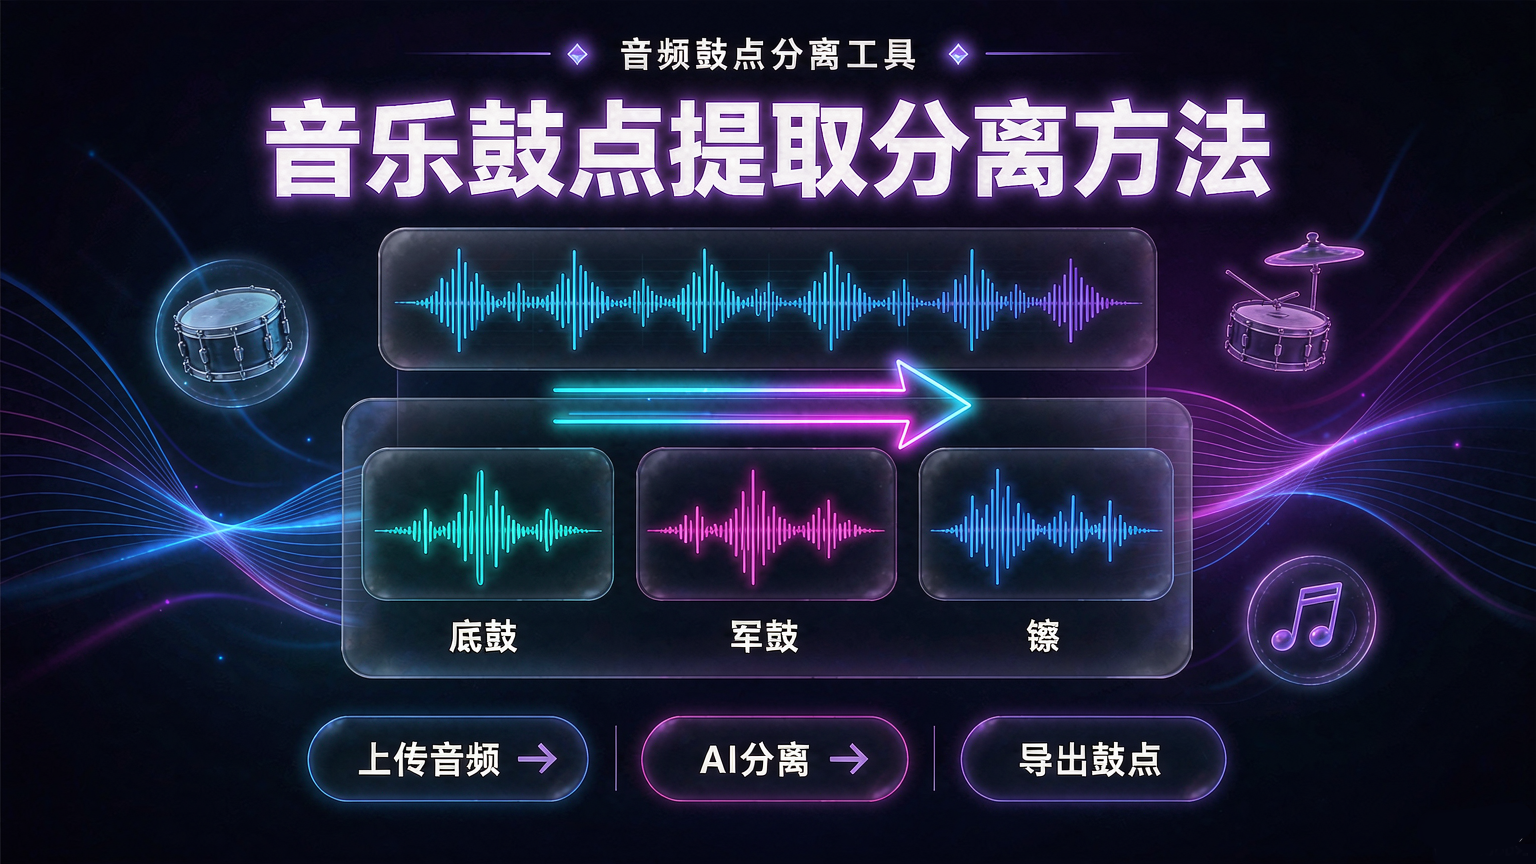
支持 6 轨精细分轨输出人声、鼓、贝斯、钢琴、其他乐器轨道;内置鼓组拆分模型,可拆解底鼓、军鼓、踩镲等鼓组独立音轨;提供伴奏定制剥离方案,适配混音、采样二次创作需求AI Fooler。
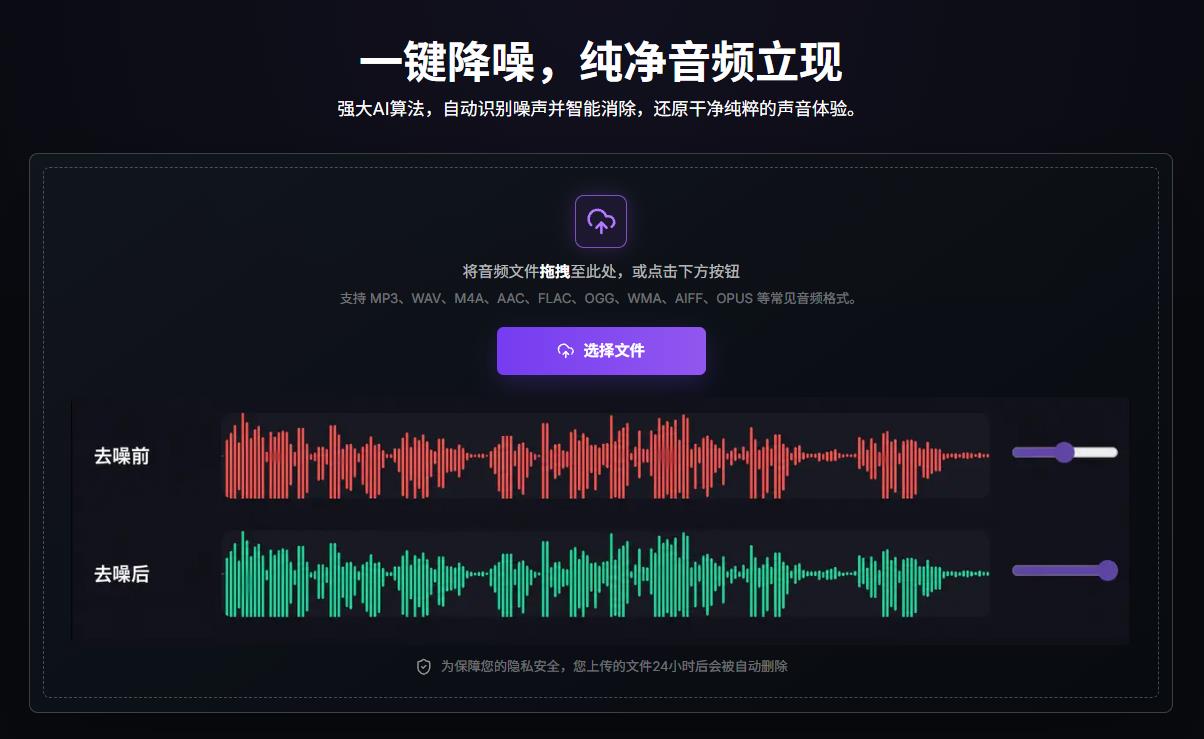
3. AI 智能降噪:
自动识别并消除环境底噪、风噪、设备噪声,保留原始人声音色,适用于采访、播客、课程录音素材修复AI Fooler。
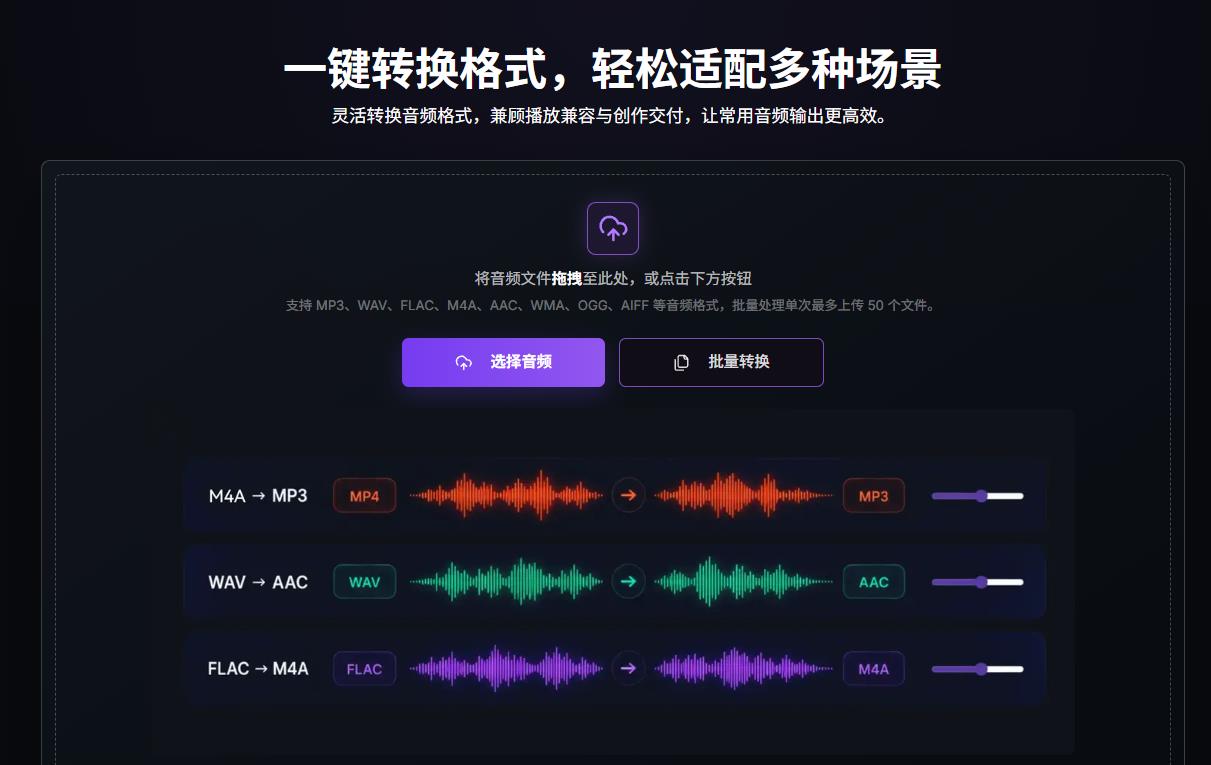
4. 音频格式转换:
支持批量音频转码,单次最多上传 50 个文件,覆盖主流音频格式互转,适配剪辑、归档、发布多类输出要求AI Fooler。
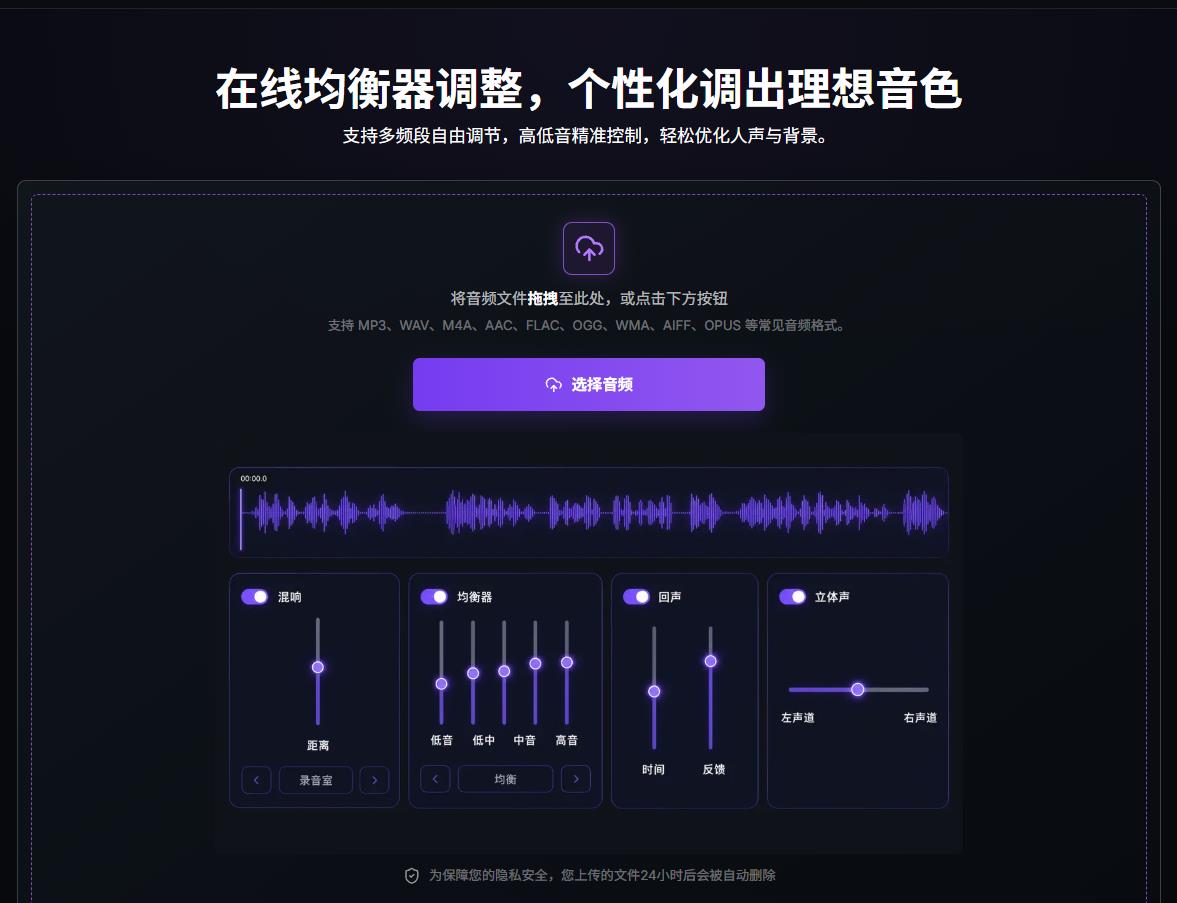
5. 在线音频均衡调节:
内置 EQ 均衡器,可手动调节低、中、高频参数,附带音色预设,支持混响、回声、立体声效果调整,实时试听修改效果AI Fooler。
6. 附加能力:
支持直接视频文件提取音轨,处理结果可在线试听后再下载导出,保留任务处理历史记录AI Fooler。
人声分离的技术原理
人声分离(aifooler)采用基于深度学习的音频源分离技术,对输入音频进行分析并识别其中不同声源的特征。
其音频处理流程通常包括音频特征分析、声源识别、音频掩模生成以及独立音轨重建等步骤。系统根据模型对人声、鼓组及其他乐器等声音特征进行区分,再生成相应的音频轨道。
网站相关音频分离模型以 Roformer系列模型为基础,并针对人声、合唱、鼓组等不同音频处理场景进行优化。
与传统通过相位抵消方式去除人声的方法不同,基于深度学习的音频源分离方法主要通过模型对不同声源进行特征识别,因此能够适用于更多类型的音频分离场景。
实际分离效果会受到歌曲编曲、声音重叠程度、录音质量以及原始音频编码等因素影响,并非所有音频都能够获得完全独立且无残留的音轨。
产品规格
1. 支持输入格式:
音频:MP3、WAV、M4A、OGG、AAC、FLAC、WMA、AIFF、OPUS;
视频:MP4、AVI、MOV、MKV、WEBM,可直接解析视频内音轨进行处理AI Fooler。
2. 输出格式:MP3、WAV、FLAC 等主流音频格式,以网页实际导出选项为准。
3. 使用方式:Web 网页在线使用,电脑、手机浏览器均可访问,无需安装软件。
4. 隐私规则:文件加密传输,处理完成 24 小时服务器自动清除用户上传源文件与生成结果文件。
5. 批量上限:格式转换功能单次最多上传 50 个文件;其余单任务处理上限以网页界面提示为准AI Fooler。
aifooler人声分离应用场景
1. 音乐学习与创作
音乐爱好者可以使用人声分离功能提取歌曲伴奏,用于翻唱练习;也可以通过多轨分离功能了解歌曲中人声、鼓、贝斯、钢琴等不同声部的组成。
对于需要进行混音、采样或编曲学习的用户,多轨音频可以作为后续分析和制作的素材。
2. 短视频与内容制作
在短视频制作过程中,可以从支持的视频文件中提取音频,并根据实际需求进行人声分离、降噪、格式转换等处理。
例如,对口播视频进行音频提取后,可以进一步处理背景噪声;对于包含音乐和人声的视频素材,则可以根据使用需求进行相应的音频分离。
3. 播客与采访录音
采访、播客和课程录音中可能存在环境噪声、设备底噪等问题。用户可以使用降噪功能对相关录音进行后期处理,以改善音频的听感。
对于不同录音环境产生的噪声,最终处理效果会有所不同。
4. 音频整理与格式转换
对于存储格式不同的音频素材,可以通过格式转换功能统一转换为常见格式,方便后续剪辑、播放和归档。
批量转换功能适用于需要同时处理多个音频文件的场景。
产品特点
人声分离(aifooler)采用网页在线处理模式,将音频分析和处理任务放在云端完成,用户端主要负责文件上传、任务提交以及结果查看。
网站集合了人声分离、多轨分轨、降噪、格式转换和均衡调节等多种音频处理功能,可以针对不同类型的音频素材进行组合处理。
需要注意的是,人工智能音频分离属于复杂的音频源分离任务,处理结果与原始素材质量、音乐编曲、声源重叠程度等因素有关,具体效果应以实际处理结果为准。